Reflection AI 发布开源权重模型 Beam,面向智能体编码并在 AWS 上线
Introducing Reflection Beam: an open-weight model for agentic coding on AWS
Reflection AI 推出开源权重模型 Beam,面向智能体编码和长周期任务,可维护代码、调用工具并处理多步工作流。
Reflection AI 开源 Beam 的权重与部署路径,读者可据此判断 501B 稀疏 MoE 在 AWS 上的落地成本与选型。
Reflection AI 推出了 Beam,这是一个开放权重模型,面向智能体编程和长周期任务,例如维护代码、使用工具、解读结果以及完成多步骤工作流。开放权重发布让开发者和研究人员能够控制运行时、部署环境和定制过程。
在本文中,我们阐述 Reflection 的愿景,并展示如何在 AWS 上部署 Beam。从 Amazon SageMaker JumpStart 实时端点开始,可获得完全托管的路径。当你需要对分布式 GPU 基础设施进行 Kubernetes 原生控制时,可使用 Amazon SageMaker HyperPod Inference 搭配 JumpStart、SGLang 或 vLLM。我们还将解释 Beam 的 5010 亿总参数如何影响检查点存储、权重内存、分片和并行性,而其 230 亿活跃参数如何影响每 token 计算。
发布时,Beam 已在 Amazon SageMaker JumpStart 中于美国东部(弗吉尼亚北部)和美国东部(俄亥俄)提供。
Reflection 对开放智能的愿景
Reflection 的使命是通过开放模型权重、发表研究成果和开源软件,让智能开放并惠及所有人。其 完整 AI 栈 涵盖模型、核心软件、生产基础设施和应用。Beam 将这一方法带给构建软件工程和智能体系统的开发者。
关于 Reflection Beam
Beam 是一个稀疏专家混合模型,用于解决软件问题、修改代码、调用工具并根据中间结果采取行动。它拥有 5010 亿总参数和 230 亿活跃参数,Reflection 报告的有效上下文长度为 100 万 token。
Reflection 通过 Hugging Face 以 Apache 2.0 许可证发布 Beam 的权重。Beam 1.0 提供 BF16、FP8 和 NVFP4 检查点变体。这些格式提供不同的内存占用和硬件兼容性。你可以使用 AWS 托管的 JumpStart 容器配置部署该模型,或在你的 AWS 环境中使用 SGLang 或 vLLM 检查和定制该模型。
了解部署架构
选择满足你的控制和扩展需求的服务路径。
- 当你想要 AWS 托管的模型包、端点和调用 API 而无需运维 Kubernetes 时,从 SageMaker JumpStart 实时端点 开始。
- 当你想要在由 Amazon Elastic Kubernetes Service (Amazon EKS) 编排的 HyperPod 集群上使用 AWS 托管的容器和模型配置时,使用 HyperPod Inference 上的 JumpStart。
- 当你需要控制服务镜像、运行时参数、量化或分布式执行时,使用 HyperPod Inference 上的 SGLang 或 vLLM。
- 根据检查点存储、权重内存、KV 缓存、上下文长度、批处理、运行时开销和受支持的并行性来确定部署规模。
- 定义预期的并发和延迟目标,然后根据实测工作负载行为配置副本、缓存、路由和自动扩缩。
JumpStart 实时路径将模型、容器和端点打包在托管部署工作流之后。HyperPod 路径公开集群和服务运行时,以便你可以控制分布式执行、缓存、路由和扩缩。
下图展示了 HyperPod 路径所使用的组件。Beam 可通过 SageMaker JumpStart、Hugging Face Hub 或可选的 Amazon Simple Storage Service(Amazon S3)镜像获取。分布式工作节点使用 AWS 托管的 JumpStart 容器或自定义的 SGLang 或 vLLM 运行时。
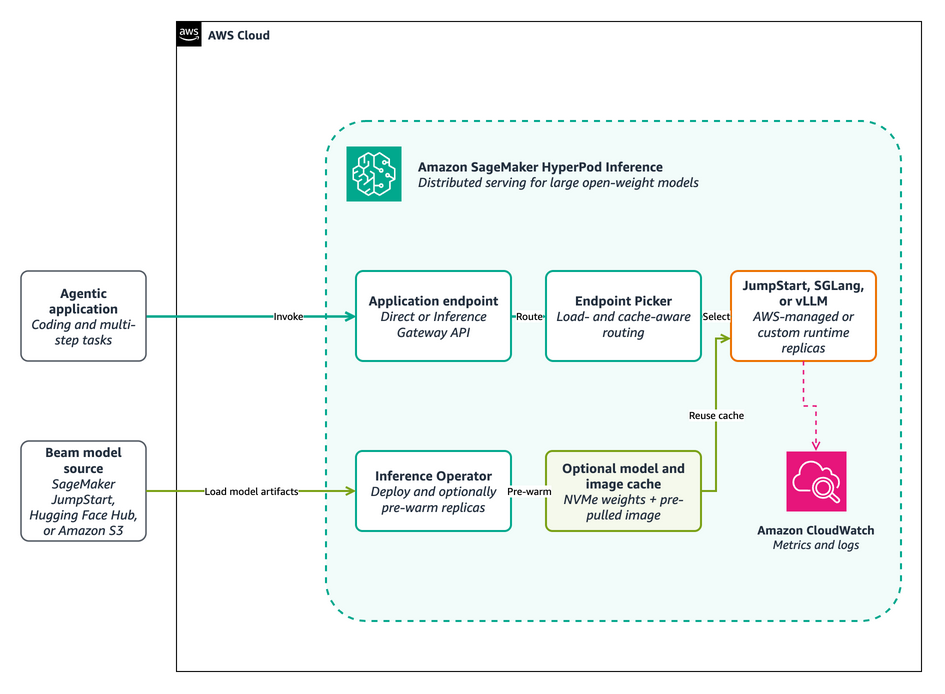
图 1:使用 Amazon SageMaker HyperPod Inference 的分布式 Beam 部署
先决条件
你需要:
- 一个 AWS 账户,并具有你所选 SageMaker 部署路径及其配套的 AWS Identity and Access Management(IAM)、网络和存储资源所需的权限。
- 通过 SageMaker JumpStart 或 Hugging Face 上的某个 Beam 1.0 checkpoint 仓库访问 Beam。
- 接受模型条款,并安装 AWS Command Line Interface(AWS CLI)和 Python 3.11 或更高版本。
- 受支持的 Beam 配置所需的 GPU 配额和容量。
规划并获取 GPU 容量
Beam 总计 5010 亿参数,需要多 GPU 部署。BF16 的权重内存需求最大,因此请规划一个多节点配置,为权重和运行时开销提供足够的聚合 GPU 内存。对于 FP8,请使用 ml.p5.48xlarge 搭配 NVIDIA H100 GPU,或使用 ml.p5e.48xlarge 和 ml.p5en.48xlarge 搭配 H200 GPU。对于 NVFP4,请使用 ml.p6-b200.48xlarge 搭配 NVIDIA B200 GPU。确认已发布的 checkpoint、运行时和并行布局支持所选的实例类型。
- 计算单个副本的权重、KV 缓存和运行时开销所需的内存,然后通过负载测试确认该估算值。
- 选择一个支持所需加速实例的 AWS 区域。
- 检查所选实例类型的服务配额和可用容量。在可用时使用按需容量,或使用 SageMaker 训练计划作为计划性工作的短期预留。
- 为镜像传输、权重下载、分片加载和运行时初始化预留时间。
路径 1:通过 SageMaker JumpStart 实时端点快速上手
当你希望以最短路径从模型目录获得托管的 HTTPS 端点时,请先使用 JumpStart 实时端点。该示例通过一条可感知变体的命令支持 BF16、FP8 和 NVFP4 模型 ID。其 README 和 Python 文件是受支持实例类型、请求架构、部署命令和清理命令的权威来源。
- Clone the sample repository.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Enter the SageMaker JumpStart deployment sample directory.
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - Create and activate a Python virtual environment.
python3 -m venv .venv source .venv/bin/activate - Install the sample dependency.
python -m pip install -r requirements.txt - Run the bounded deployment, invocation, and cleanup lifecycle for FP8.
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
该命令会部署 FP8 端点、发送一个简短请求、打印响应并清理端点。使用
bf16或nvfp4选择其他 checkpoint 变体;省略--variant时,NVFP4 为默认值。当你需要保持端点持续运行时,请使用 README 中的 Python 函数。
路径 2:使用 SageMaker HyperPod Inference 部署
当你需要对分布式 GPU 基础设施进行 Kubernetes 原生控制时,请使用 HyperPod Inference。你可以使用 AWS 托管的 JumpStart 容器配置,或使用 SGLang 或 vLLM 部署 Beam。HyperPod Inference 部署示例 README及其配置文件是已发布清单、模型和镜像标识符、受支持运行时版本以及命令的权威来源。
开始之前,请配置 kubectl 对由 EKS 编排的 HyperPod 集群的访问,并安装 HyperPod Inference Operator 及所需附加组件。你还需要集群虚拟私有云(VPC)、子网、安全组、对所选 Beam 和运行时构件的访问权限,以及启用模型缓存时的本地 NVMe 容量。如果所选仓库需要身份验证,请使用隔离的 Hugging Face 访问令牌。
从 Hugging Face Hub 部署固定版本的 Beam 修订版,用于开发和实验。对于生产部署和模型缓存,请将检查点复制到 Amazon S3 或 Amazon FSx。HyperPod 模型和镜像缓存可以将权重预加载到节点本地 NVMe 存储,并预拉取服务镜像。
HyperPod 推理网关提供 OpenAI 兼容接口,并在各副本之间路由请求。HyperPod 推理还支持托管分层 KV 缓存和智能路由。这些都属于2026 年推出的 Amazon SageMaker 推理功能。
下一张图展开了模型准备和运行时请求流程。启用模型缓存后,Inference Operator 会使用选定的权重和服务镜像预热符合条件的节点。在运行时,Inference Gateway 和 Endpoint Picker 可以将每个请求定向到合适的 JumpStart 托管、SGLang 或 vLLM 副本。
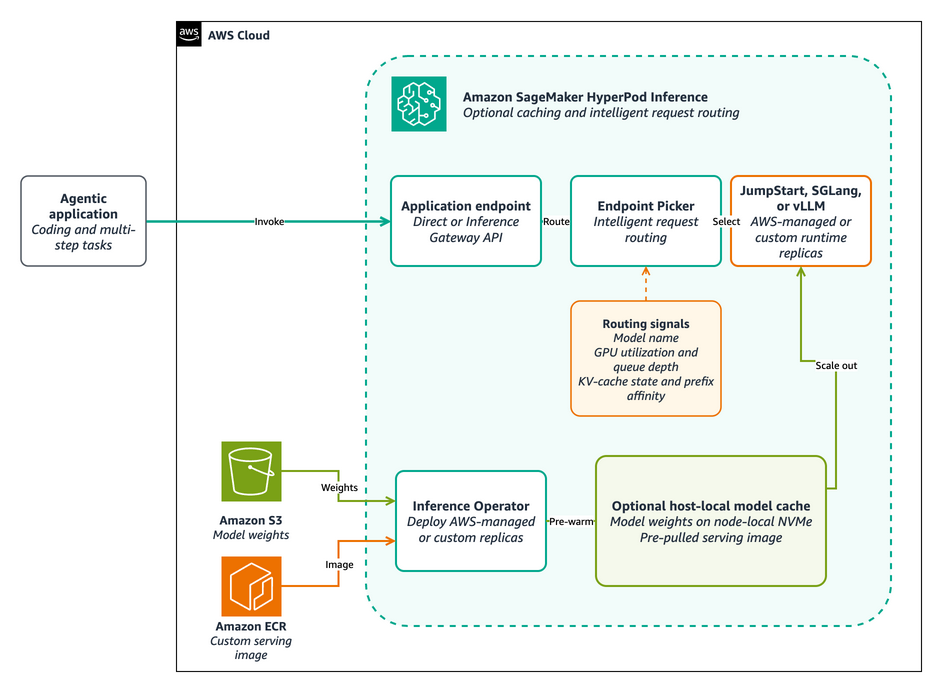
图 2:HyperPod 模型缓存和请求路由
准备部署工件
使用不可变输入,以便复现部署和性能结果。
- 使用部署示例中记录的 JumpStart 模型版本。
- 为自定义运行时选择 BF16、FP8 或 NVFP4 检查点。
- 对于自定义运行时,请在示例版本配置中保留公开的 Beam 提交 SHA 和镜像摘要。
- 仅当你的集群无法拉取上游镜像,或你的组织要求使用经批准的注册表时,才将发布的镜像镜像到私有的 Amazon Elastic Container Registry(Amazon ECR)存储库。
- 不要将令牌、生成的密钥、私有模型 ID、注册表凭证和未发布的结果保留在存储库中。
选择服务路径
除非你的工作负载需要特定的推理运行时或配置,否则请从 SageMaker JumpStart 开始。
| 服务路径 | 适用场景 | 你需要管理的内容 |
| SageMaker JumpStart | 你希望使用 AWS 托管的容器和模型配置,并减少运行时维护工作。 | 选择 Beam 模型版本、支持的实例类型、端点配置和扩缩策略。 |
| SGLang 或 vLLM | 你需要特定的推理运行时或配置,例如自定义运行时参数、解析器、量化或并行。 | 固定支持的运行时镜像、模型修订版、解析器配置和分布式执行设置。 |
使用 SageMaker JumpStart 部署
SageMaker JumpStart 减少了容器集成工作,同时 HyperPod 保留对集群容量、扩缩和可观测性的控制。
- 在 SageMaker Studio 中,打开 JumpStart 模型目录。
- 在 所有公开模型下,选择 Beam。
- 选择 SageMaker HyperPod 作为部署目标。
- 选择集群和 Kubernetes 命名空间。
- 输入端点名称,然后选择 部署。
- 在使用发布的 JumpStart 请求架构调用端点之前,确认部署状态。
对于基础设施即代码工作流,请使用 HyperPod 示例中发布的 JumpStart 配置。你可以在配置部署之前检查 reflection-beam-jumpstart.yaml 清单模板。
- Clone the sample repository, and enter the HyperPod Beam directory.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Create the local configuration files described in the README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validate the JumpStart configuration before changing the cluster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - Deploy the JumpStart configuration.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
该辅助工具会渲染并应用发布的 JumpStartModel 资源,而不会将填充后的发布值写入磁盘。
使用 SGLang 或 vLLM 部署
当你需要对服务运行时进行直接控制时,选择 SGLang 或 vLLM。在配置部署之前,请查看 reflection-beam-sglang.yaml 清单模板 或 reflection-beam-vllm.yaml 清单模板。示例 README 仍然是已发布值和命令的权威来源。
- Clone the sample repository.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Enter the HyperPod Beam directory.
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Create the local configuration files described in the README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validate the selected configuration before changing the cluster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - Deploy Beam, and wait for a terminal deployment state.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
将
sglang替换为vllm以使用 vLLM。该辅助工具会验证所选设置,应用渲染后的清单而不将发布值写入磁盘,以固定超时等待,并在部署失败时打印诊断信息。
调用 Beam
使用已发布的模型请求架构调用 JumpStart 端点。对于 SGLang 或 vLLM,请使用 HyperPod 示例中包含的有界冒烟测试。
调用已部署的端点
- Install the sample client dependency.
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - Run a private health check and short request with the recommended starting sampling settings.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
对于 vLLM 部署,将
sglang替换为vllm。该辅助工具会选择一个就绪的工作节点,打开临时端口转发,检查端点健康状况,发送请求,然后关闭端口转发。
响应类似于以下内容:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
对于经过身份验证的 Inference Gateway,请使用 HyperPod 示例 README 中的持有者令牌流程。请勿将凭证放入源代码、清单和命令历史记录中。
衡量并调优性能
- 在预期并发下,使用重复的、具有代表性的编码和工具使用请求测试每条服务路径。
- 记录 Beam 模型版本、镜像摘要、实例类型、精度、上下文长度、并行度、服务参数、缓存状态和测试重复次数。
- 衡量请求成功率、p50 和 p95 首令牌时间、每输出令牌时间、端到端延迟以及每秒聚合输出令牌数。
- 根据这些结果调优批大小、KV 缓存分配、副本数、自动扩缩以及模型和镜像缓存。
- 更改精度或量化后,重新检查输出质量。
清理
测试完成后删除资源,以避免持续产生费用。
- 对于 SageMaker JumpStart 实时端点,请遵循 SageMaker JumpStart 部署示例 README 中的清理说明。
- 对于 Amazon SageMaker HyperPod Inference 上的 JumpStart、SGLang 或 vLLM,请遵循 HyperPod Inference 部署示例 README 中的清理说明。
- 删除为本次演练创建的专用 HyperPod 或 Amazon EKS 集群。
- 删除未使用的缓存权重、镜像产物、负载均衡器、日志组、临时 IAM 角色和捕获的推理数据。
结论
Reflection Beam 为开发者提供了一个专为智能体编码和多步骤任务设计的开放权重模型。从 SageMaker JumpStart 实时端点开始,实现完全托管的部署。当你需要 Kubernetes 原生基础设施控制而不想管理服务容器时,使用 SageMaker HyperPod Inference 搭配 JumpStart;当你需要自定义运行时,选择 SGLang 或 vLLM。
使用 SageMaker JumpStart 部署示例 或 HyperPod Inference 部署示例,然后按照说明操作。
要了解有关 Reflection AI 及其开放智能愿景的更多信息,请访问 Reflection AI 并阅读 Introducing Beam。
资源
- Reflection Beam 检查点变体:BF16、FP8 和 NVFP4
- SageMaker JumpStart 部署示例
- 使用 JumpStart、vLLM 和 SGLang 的 HyperPod Inference 部署示例
- 将 SageMaker JumpStart 中的基础模型部署到 HyperPod Inference
- Amazon SageMaker Inference 2026 年迄今发布回顾
关于作者

Clement Perrot
Clement 是 Reflection AI 的创始应用 AI 负责人。在加入 Reflection AI 之前,他曾在 AWS 的生成式 AI 创新中心工作,并创立了 AI 和消费硬件初创公司,其中两家被收购。

Florent Gbelidji
Florent 是 Reflection AI 的开源工程负责人和技术人员。在加入 Reflection AI 之前,他领导了 Hugging Face 与 AWS 的云合作,并担任机器学习工程师,帮助公司构建开源 AI 解决方案。

Daniel Quang
Daniel 是 AWS 前沿 AI 初创团队的一名解决方案架构师,他帮助全球最大和最具战略意义的生成式 AI 初创公司在 AWS 上扩展其基础设施。他拥有加州大学欧文分校的计算机科学博士学位,研究方向为机器学习和生物信息学。

Hadrien Almela
Hadrien 是 AWS 初创团队的高级前沿 AI 客户经理,帮助顶尖 AI 初创公司建立技术集成和全球市场推广合作伙伴关系。他在初创领域拥有八年经验。Hadrien 住在加利福尼亚州旧金山,喜欢潜水、冲浪和前往异国他乡旅行。

Dan Ferguson
Dan 是 AWS 驻纽约的生成式 AI 全球高级专家解决方案架构师。他帮助客户高效、有效且可持续地集成机器学习和生成式 AI 工作负载。

Daniel Wirjo
Daniel 是 AWS 的一名解决方案架构师,专注于 AI 和 SaaS 初创公司。作为前初创公司 CTO,他喜欢与创始人和工程领导者合作,在 AWS 上推动增长和创新。工作之余,Daniel 喜欢手捧咖啡散步、欣赏自然和学习新想法。

Sureshkumar Natarajan
Sureshkumar 是 Amazon Web Services 的高级技术客户经理。他帮助企业管理客户加速其云现代化之旅,并且是下一代开发者体验技术领域社区的成员,支持 AWS Transform custom。
来源:AWS Machine Learning Blog · aws.amazon.com