NVIDIA DGX Spark 推出 64GB 版本,支持双机集群扩展本地 AI
NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI
NVIDIA 将于本月通过 Acer、ASUS、Dell、Gigabyte、HP 和 MSI 推出 64GB 统一内存版 DGX Spark,10 月 23 日开售,起售价 4,999 美元,保留 GB10 Grace Blackwell 超级芯片、DGX OS 和完整 NVIDIA AI 软件栈,支持最高 1000 亿参数模型在设备端运行。
原文给出 64GB 新配置的价格、上市时间与双机集群性能数据,可据此判断本地跑大模型的成本与扩展方式。
本地 AI 正变得愈发实用。
随着 AI 智能体从实验走向日常开发,能力日益强大的开放模型不断缩小体积以适配更多设备,让开发者能在本地运行更多内容。
本月即将推出,NVIDIA DGX Spark 将携手顶级制造商合作伙伴——宏碁、华硕、戴尔、技嘉、惠普和微星——推出配备 64GB 统一内存的版本,为开发者、研究人员和 AI 爱好者带来全新配置,搭载 DGX OS 和 NVIDIA AI 软件栈,开箱即用。
全新 SKU 可在设备上运行强大的本地智能体——私密运行,无需依赖云端。当工作负载增长时,两台设备可通过 NVIDIA Sync Cluster Assistant 集群互联,无需任何额外设置。
个人 AI 超级计算的新起点
DGX Spark 将 NVIDIA Grace Blackwell 计算、统一内存、NVIDIA ConnectX-7 网络和NVIDIA CUDA加速的 AI 软件栈整合于一个系统中。它是一个完整的本地 AI 平台,适用于智能体、推理、微调、数据科学和边缘开发。
这款紧凑的个人 AI 超级计算机提供了一个平台,让开发者可以用模型和自己的数据进行实验,而无需为每项任务都求助于云实例。
全新 64GB 配置仅通过制造商合作伙伴提供,在保持平台价格亲民的同时,保留了 GB10 Grace Blackwell 超级芯片、DGX OS 和完整的 NVIDIA AI 软件栈——与 128GB 型号相同。它支持高达 1000 亿参数的模型以及基于这些模型构建的智能体应用,完全在设备上运行。
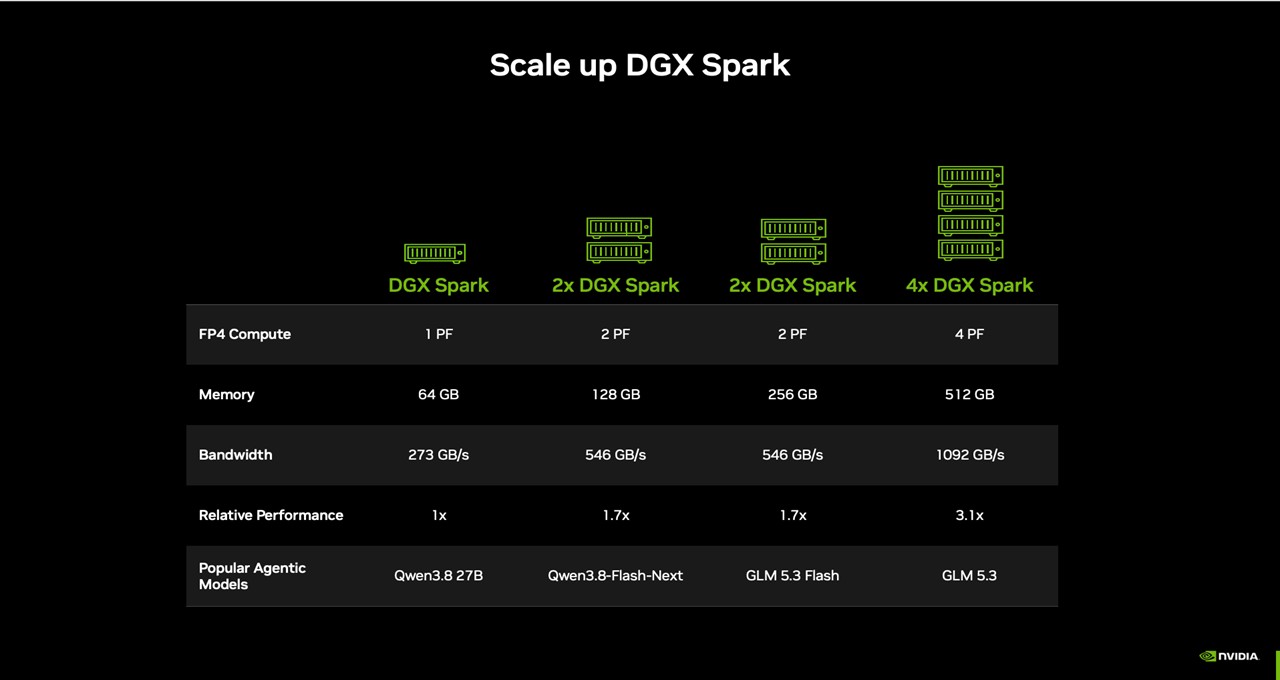
两台 64GB 设备集群互联不只是内存翻倍。在 NVIDIA 的 Qwen 3.8 27B 测试中,两台集群的 64GB 系统相比单台系统性能提升高达 1.7 倍,并且随着工作负载需求增长还有继续扩展的空间。
DGX Spark 开箱即支持智能体开发——NVIDIA Agent Toolkit、CUDA-X AI 库、Nemotron 开放模型,以及 Ollama、vLLM 和带 CUDA 的 PyTorch 等流行运行时均开箱即用。开发者可以在几分钟内从开机到运行模型。
Blender 是首批支持该平台的主要创作者应用提供商之一,预构建的可下载安装程序即将推出。
借助 NVIDIA Sync Cluster Assistant 扩展
开发者可以从项目当前所需的内存起步,并基于一个旨在随着流水线增长而无缝扩展多节点集群以应对更大工作负载的平台进行构建。
每台 DGX Spark 开箱即内置 NVIDIA ConnectX-7 网卡。此外,两台设备可通过 QSFP 线缆直接连接,将内存池化至 128GB,并将模型支持扩展至高达 2000 亿参数,同时提供两倍内存带宽和高达 1.7 倍的性能。
NVIDIA Sync 应用可无缝配置此多节点集群。集群助手功能会检测已连接的设备、验证设备配置并配置 ConnectX-7 网络,因此开发者可以专注于自己的工作,而无需操心基础设施。每个节点都运行相同的 NVIDIA 软件栈,因此从一台设备扩展到两台时无需重新配置任何内容。
本月底即将推出的 NVIDIA Sync Model Launcher 让运行本地 AI 变得像点击几个按钮一样简单。开发者可以在单台 DGX Spark 系统或集群上下载并启动 Qwen3.8 27B,NVIDIA Sync 会配置模型以在已连接的设备上运行,并使其可从用户的笔记本电脑访问。该启动器还将设置 OpenCode 以使用该模型,因此开发者可以直接在浏览器中开始编码。
DGX Spark 上的开发者用例
全新的 DGX Spark 64GB 配置从第一天起就支持实际工作。凭借完全在设备上运行的高达 1000 亿参数的模型,开发者和爱好者可以从单台系统开始运行适合其内存的模型,或通过 NVIDIA Sync Cluster Assistant 连接多台 DGX Spark 系统,以应对需要更多内存和计算能力的工作负载。
以下是三个工作流示例:
- 全天候运行 AI 智能体:让编码或研究智能体在 DGX Spark 上持续运行,随时准备审查代码、分析文档或执行多步骤任务。集群可为更大的模型、更长的上下文窗口或多个智能体同时工作提供额外容量。
- 为你的日常 PC 提供 AI 应用支持:在 DGX Spark 上运行语言或图像生成模型,同时在笔记本电脑或台式机上使用智能体或创意应用。DGX Spark 负责模型推理,让 PC 腾出资源处理其他工作。
- 随工作增长而扩展:当单个任务超出一台设备的承载能力时——例如运行更大的模型、更长的上下文窗口或并发的智能体请求——通过 NVIDIA Sync Cluster Assistant 将两台 DGX Spark 64GB 系统经 200 GbE 网络连接,即可将内存池化至 128GB。原本在单台设备上运行的工作流可扩展到两台,而无需重新配置软件环境。
开始使用 DGX Spark
DGX Spark 64GB 将于 10 月 23 日星期五起在 Acer、ASUS、Dell、Gigabyte、HP 和 MSI 发售,起售价 4,999 美元。
开始使用:
- 下载受支持的推理框架——llama.cpp、Ollama、vLLM 或 LM Studio。
- 下载该工作流推荐的本地模型。
- 要扩展到两台设备,请通过其 NVIDIA ConnectX-7 端口连接它们并启动 NVIDIA Sync Cluster Assistant——它会自动配置网络并路由工作负载。
有关 DGX Spark 上的智能体 AI 操作指南,请访问 build.nvidia.com 上的 NemoClaw、 OpenClaw、 Hermes Agent 和 OpenShell 页面。
#ICYMI:更多来自 NVIDIA 本地 AI 的更新
在 build.nvidia.com/spark 上探索面向 DGX Spark 的 playbook。以下 playbook 即将登陆 64GB 设备:
- 使用 vLLM 部署 LLM
- 使用本地 LLM 运行 OpenClaw
- 连接多台 DGX Spark 以运行分布式工作负载
搭载 NVIDIA RTX Spark 的全新 Windows PC 将于本月由 Acer、ASUS、Dell、HP、Lenovo、Microsoft 和 MSI 推出。订阅 RTX Spark 新闻通讯 以获取后续更新。
阿里巴巴的 Qwen-Image-2.1 将图像生成与编辑整合到一个轻量级开放权重模型中。它可在 NVIDIA RTX GPU、DGX Spark 和 DGX Station 上本地运行,为创作者提供更多在自己的硬件上创建和优化图像的方式。
在 X、Instagram、TikTok 和 Facebook 上关注 NVIDIA RTX Spark——并订阅 NVIDIA Local AI 新闻通讯 以随时了解最新动态。在 LinkedIn 和 X 上关注 NVIDIA Workstation。
请参阅 关于软件产品信息的声明。
来源:NVIDIA Blog · blogs.nvidia.com